Domain cgrr.de kaufen?
Wir ziehen mit dem Projekt
cgrr.de um.
Sind Sie am Kauf der Domain
cgrr.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain cgrr.de kaufen?
Wie kann Textextraktion bei der Automatisierung von Dokumentenprozessen helfen? Welche Tools oder Methoden eignen sich für die effiziente Textextraktion aus verschiedenen Quellen?
Textextraktion kann bei der Automatisierung von Dokumentenprozessen helfen, indem sie Informationen aus unstrukturierten Dokumenten extrahiert und in strukturierte Daten umwandelt. Tools wie OCR (Optical Character Recognition), NLP (Natural Language Processing) und Machine Learning eignen sich für die effiziente Textextraktion aus verschiedenen Quellen wie PDFs, Scans und Bildern. Diese Tools können dabei helfen, den manuellen Aufwand zu reduzieren und die Genauigkeit der Datenextraktion zu verbessern. **
Wie kann Textextraktion zur automatischen Datenauswertung in Unternehmen eingesetzt werden?
Textextraktion kann genutzt werden, um relevante Informationen aus großen Mengen unstrukturierter Daten zu extrahieren. Diese extrahierten Daten können dann automatisch analysiert und in strukturierte Formate umgewandelt werden. Dadurch können Unternehmen effizienter arbeiten, Kosten senken und fundierte Entscheidungen auf Basis der extrahierten Daten treffen. **
Ähnliche Suchbegriffe für Textextraktion
Top-Angebote
Produkte zum Begriff Textextraktion:
-
Braun, Jutta: Wettkampf der SystemeWettkampf der Systeme , Unter dem Einfluss der deutschen Teilung entwickelten sich sowohl der Breiten- als auch der Spitzensport unter verschiedenen Vorzeichen. Während der Sport im Westen vor allem im Vereinswesen verankert war, wurde er im Osten staatlich organisiert. Im Rahmen internationaler Großereignisse wie den Olympischen Spielen oder Weltmeisterschaften trafen beide Sportsysteme aufeinander und wurden zu Stellvertretern im Wettbewerb der politischen Systeme. Jutta Braun beschreibt die Entwicklungen beiderseits der Mauer bis hin zum gemeinsamen 'Lauf' in die Einheit 1989/1990. Sie analysiert die Rolle herausragender Sportidole und legendärer Begegnungen wie der Fußball-WM 1974, beleuchtet den Schattenbereich des Dopings mit seinen jeweils spezifischen Ausprägungen und nimmt zugleich die Rolle der Fans und ihrer Subkultur in den Blick. , Kontrollventile > Ventile & Ventilsteuerungsteile , Erscheinungsjahr: 20240618, Produktform: Leinen, Autoren: Braun, Jutta, Redaktion: Creuzberger, Stefan~Geppert, Dominik~Hoffmann, Dierk, Seitenzahl/Blattzahl: 192, Abbildungen: 30 s/w-Abbildungen, Keyword: Breitensport; Bundesrepublik; DDR; Doping; Olympische Spiele; Sport; Sportgeschichte; Vereinssport; Weltmeisterschaft; Wettbewerb; Wiedervereinigung; deutsche Teilung, Fachschema: DDR~Deutschland / DDR~Deutschland / Westdeutschland~Westdeutschland~Bundesrepublik Deutschland~Europa / Geschichte, Kulturgeschichte~Kalter Krieg~Krieg / Kalter Krieg~Sport / Geschichte, Fachkategorie: Europäische Geschichte~Geschichte des Sports, Warengruppe: HC/Zeitgeschichte/Politik (ab 1949), UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Länge: 216, Breite: 141, Höhe: 21, Gewicht: 347, Produktform: Gebunden, Genre: Geisteswissenschaften/Kunst/Musik,22,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter


-
Wie kann Textextraktion dazu beitragen, Informationen aus unstrukturierten Dokumenten schneller und effizienter zu gewinnen? Gibt es bestimmte Tools oder Methoden, die sich besonders gut für die Textextraktion eignen?
Textextraktion ermöglicht es, relevante Informationen aus unstrukturierten Dokumenten automatisch zu extrahieren, was den Prozess beschleunigt und die Effizienz steigert. Tools wie OCR (Optical Character Recognition) und NLP (Natural Language Processing) sind besonders gut geeignet, um Textextraktion durchzuführen. Durch den Einsatz dieser Technologien können Unternehmen Zeit und Ressourcen sparen und wertvolle Erkenntnisse aus ihren Dokumenten gewinnen. **
-
Wie funktioniert die automatische Textextraktion aus Bilddateien? Welche Technologien werden dabei eingesetzt?
Die automatische Textextraktion aus Bilddateien erfolgt mithilfe von optischer Zeichenerkennung (OCR), bei der Text auf einem Bild in maschinenlesbaren Text umgewandelt wird. Diese Technologie nutzt komplexe Algorithmen, um Buchstaben, Zahlen und Symbole zu identifizieren und zu extrahieren. Anschließend kann der extrahierte Text weiterverarbeitet oder analysiert werden. **
-
Inwiefern kann Textextraktion dazu beitragen, Informationen aus großen Textmengen effizienter zu gewinnen und zu nutzen?
Textextraktion kann helfen, relevante Informationen aus großen Textmengen automatisch zu identifizieren und zu extrahieren. Dadurch wird die manuelle Durchsicht und Auswertung von Texten deutlich beschleunigt. Die gewonnenen Informationen können dann effizienter genutzt werden, z.B. für Analysen, Berichte oder Entscheidungsfindungen. **
-
Welche Tools oder Techniken können für die Textextraktion aus Bildern oder PDF-Dateien verwendet werden?
Optische Zeichenerkennung (OCR) ist ein häufig verwendetes Tool zur Textextraktion aus Bildern oder PDF-Dateien. Es wandelt gedruckten oder handgeschriebenen Text in maschinenlesbaren Text um. Andere Techniken wie Texterkennungsalgorithmen können ebenfalls zur Extraktion von Text aus Bildern oder PDF-Dateien verwendet werden. **


Wie funktioniert die Textextraktion aus Bildern oder PDF-Dateien? Welche Technologien oder Tools werden dafür typischerweise verwendet?
Die Textextraktion aus Bildern oder PDF-Dateien erfolgt durch optische Zeichenerkennung (OCR), bei der Text aus Bilddateien in maschinenlesbaren Text umgewandelt wird. Typische Technologien und Tools für die Textextraktion sind Adobe Acrobat, Tesseract, ABBYY FineReader und Google Cloud Vision API. Diese Tools verwenden komplexe Algorithmen, um Text aus Bildern oder PDFs zu extrahieren und in editierbare Formate umzuwandeln. **
Wie funktioniert die Textextraktion aus Bildern oder PDF-Dateien? Welche Tools oder Software eignen sich dafür am besten?
Die Textextraktion aus Bildern oder PDF-Dateien erfolgt mithilfe von OCR (Optical Character Recognition) Technologie, die gedruckten oder handgeschriebenen Text in digitale Zeichen umwandelt. Tools wie Adobe Acrobat, ABBYY FineReader und Tesseract sind beliebte Optionen für die Textextraktion aus Bildern oder PDF-Dateien. Diese Tools können den Text erkennen, extrahieren und in editierbare Formate wie Word oder Excel konvertieren. **
Top-Angebote
Produkte zum Begriff Textextraktion:
-
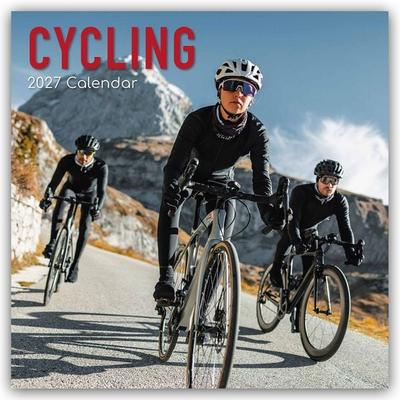
Cycling – Fahrradfahren – Fahrrad – Radsport 2027 – 16-MonatskalenderDer Praktische 16-monats-kalender Von Gifted Stationery Co. Ltd Ist Zum Aufklappen (30,5 X 30,5 Cm, Aufgeklappt 30,5 X 61 Cm). Er Bietet 12 Verschiedene, Sorgfältig Ausgewählte Bilder Mit Meist Kurzen Informationen Zum Thema. Das Große,...14,95 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
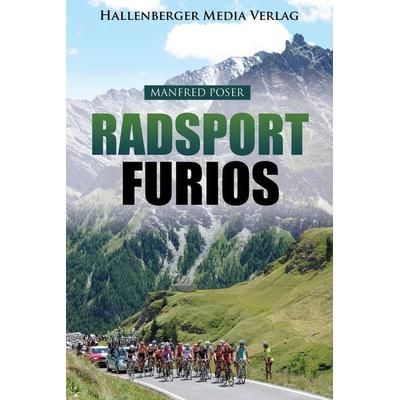
Radsport furios: Etappensieger und Wasserträger - Rennrad-Geschichte und Geschichten von den großen Radrennen, Taschenbuch von Manfred Poser,Radsport Furios: Etappensieger Und Wasserträger - Rennrad-geschichte Und Geschichten Von Den Großen Radrennen, Taschenbuch Von Manfred Poser, Hallenberger Media Gmbh, 978-3-95764-203-5, Seitenanzahl: 33414,99 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Braun, Jutta: Wettkampf der SystemeWettkampf der Systeme , Unter dem Einfluss der deutschen Teilung entwickelten sich sowohl der Breiten- als auch der Spitzensport unter verschiedenen Vorzeichen. Während der Sport im Westen vor allem im Vereinswesen verankert war, wurde er im Osten staatlich organisiert. Im Rahmen internationaler Großereignisse wie den Olympischen Spielen oder Weltmeisterschaften trafen beide Sportsysteme aufeinander und wurden zu Stellvertretern im Wettbewerb der politischen Systeme. Jutta Braun beschreibt die Entwicklungen beiderseits der Mauer bis hin zum gemeinsamen 'Lauf' in die Einheit 1989/1990. Sie analysiert die Rolle herausragender Sportidole und legendärer Begegnungen wie der Fußball-WM 1974, beleuchtet den Schattenbereich des Dopings mit seinen jeweils spezifischen Ausprägungen und nimmt zugleich die Rolle der Fans und ihrer Subkultur in den Blick. , Kontrollventile > Ventile & Ventilsteuerungsteile , Erscheinungsjahr: 20240618, Produktform: Leinen, Autoren: Braun, Jutta, Redaktion: Creuzberger, Stefan~Geppert, Dominik~Hoffmann, Dierk, Seitenzahl/Blattzahl: 192, Abbildungen: 30 s/w-Abbildungen, Keyword: Breitensport; Bundesrepublik; DDR; Doping; Olympische Spiele; Sport; Sportgeschichte; Vereinssport; Weltmeisterschaft; Wettbewerb; Wiedervereinigung; deutsche Teilung, Fachschema: DDR~Deutschland / DDR~Deutschland / Westdeutschland~Westdeutschland~Bundesrepublik Deutschland~Europa / Geschichte, Kulturgeschichte~Kalter Krieg~Krieg / Kalter Krieg~Sport / Geschichte, Fachkategorie: Europäische Geschichte~Geschichte des Sports, Warengruppe: HC/Zeitgeschichte/Politik (ab 1949), UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Länge: 216, Breite: 141, Höhe: 21, Gewicht: 347, Produktform: Gebunden, Genre: Geisteswissenschaften/Kunst/Musik,22,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Wie kann Textextraktion bei der Automatisierung von Dokumentenprozessen helfen? Welche Tools oder Methoden eignen sich für die effiziente Textextraktion aus verschiedenen Quellen?
Textextraktion kann bei der Automatisierung von Dokumentenprozessen helfen, indem sie Informationen aus unstrukturierten Dokumenten extrahiert und in strukturierte Daten umwandelt. Tools wie OCR (Optical Character Recognition), NLP (Natural Language Processing) und Machine Learning eignen sich für die effiziente Textextraktion aus verschiedenen Quellen wie PDFs, Scans und Bildern. Diese Tools können dabei helfen, den manuellen Aufwand zu reduzieren und die Genauigkeit der Datenextraktion zu verbessern. **
-
Wie kann Textextraktion zur automatischen Datenauswertung in Unternehmen eingesetzt werden?
Textextraktion kann genutzt werden, um relevante Informationen aus großen Mengen unstrukturierter Daten zu extrahieren. Diese extrahierten Daten können dann automatisch analysiert und in strukturierte Formate umgewandelt werden. Dadurch können Unternehmen effizienter arbeiten, Kosten senken und fundierte Entscheidungen auf Basis der extrahierten Daten treffen. **
-
Wie kann Textextraktion dazu beitragen, Informationen aus unstrukturierten Dokumenten schneller und effizienter zu gewinnen? Gibt es bestimmte Tools oder Methoden, die sich besonders gut für die Textextraktion eignen?
Textextraktion ermöglicht es, relevante Informationen aus unstrukturierten Dokumenten automatisch zu extrahieren, was den Prozess beschleunigt und die Effizienz steigert. Tools wie OCR (Optical Character Recognition) und NLP (Natural Language Processing) sind besonders gut geeignet, um Textextraktion durchzuführen. Durch den Einsatz dieser Technologien können Unternehmen Zeit und Ressourcen sparen und wertvolle Erkenntnisse aus ihren Dokumenten gewinnen. **
-
Wie funktioniert die automatische Textextraktion aus Bilddateien? Welche Technologien werden dabei eingesetzt?
Die automatische Textextraktion aus Bilddateien erfolgt mithilfe von optischer Zeichenerkennung (OCR), bei der Text auf einem Bild in maschinenlesbaren Text umgewandelt wird. Diese Technologie nutzt komplexe Algorithmen, um Buchstaben, Zahlen und Symbole zu identifizieren und zu extrahieren. Anschließend kann der extrahierte Text weiterverarbeitet oder analysiert werden. **
Ähnliche Suchbegriffe für Textextraktion
-
Inwiefern kann Textextraktion dazu beitragen, Informationen aus großen Textmengen effizienter zu gewinnen und zu nutzen?
Textextraktion kann helfen, relevante Informationen aus großen Textmengen automatisch zu identifizieren und zu extrahieren. Dadurch wird die manuelle Durchsicht und Auswertung von Texten deutlich beschleunigt. Die gewonnenen Informationen können dann effizienter genutzt werden, z.B. für Analysen, Berichte oder Entscheidungsfindungen. **
-
Welche Tools oder Techniken können für die Textextraktion aus Bildern oder PDF-Dateien verwendet werden?
Optische Zeichenerkennung (OCR) ist ein häufig verwendetes Tool zur Textextraktion aus Bildern oder PDF-Dateien. Es wandelt gedruckten oder handgeschriebenen Text in maschinenlesbaren Text um. Andere Techniken wie Texterkennungsalgorithmen können ebenfalls zur Extraktion von Text aus Bildern oder PDF-Dateien verwendet werden. **
-
Wie funktioniert die Textextraktion aus Bildern oder PDF-Dateien? Welche Technologien oder Tools werden dafür typischerweise verwendet?
Die Textextraktion aus Bildern oder PDF-Dateien erfolgt durch optische Zeichenerkennung (OCR), bei der Text aus Bilddateien in maschinenlesbaren Text umgewandelt wird. Typische Technologien und Tools für die Textextraktion sind Adobe Acrobat, Tesseract, ABBYY FineReader und Google Cloud Vision API. Diese Tools verwenden komplexe Algorithmen, um Text aus Bildern oder PDFs zu extrahieren und in editierbare Formate umzuwandeln. **
-
Wie funktioniert die Textextraktion aus Bildern oder PDF-Dateien? Welche Tools oder Software eignen sich dafür am besten?
Die Textextraktion aus Bildern oder PDF-Dateien erfolgt mithilfe von OCR (Optical Character Recognition) Technologie, die gedruckten oder handgeschriebenen Text in digitale Zeichen umwandelt. Tools wie Adobe Acrobat, ABBYY FineReader und Tesseract sind beliebte Optionen für die Textextraktion aus Bildern oder PDF-Dateien. Diese Tools können den Text erkennen, extrahieren und in editierbare Formate wie Word oder Excel konvertieren. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.